
Prompt Injection ve Data Leakage: AI-Native Sistemlerde Güvenlik Katmanı (Guardrails) İnşası
Kurumsal yapay zeka sistemleri iş süreçlerine entegre oldukça güvenlik riskleri de yeni bir boyut kazanıyor. Geleneksel siber güvenlik yaklaşımları; ağları, uygulamaları ve kullanıcı erişimlerini korumaya odaklanırken, üretken yapay zeka sistemleri farklı saldırı yüzeyleri oluşturuyor. Özellikle kurumsal bilgi tabanlarıyla çalışan AI Agent’ler, Retrieval-Augmented Generation (RAG) mimarileri ve çok ajanlı yapılar, güvenlik ekiplerini daha önce karşılaşmadıkları risk senaryolarıyla karşı karşıya bırakıyor.
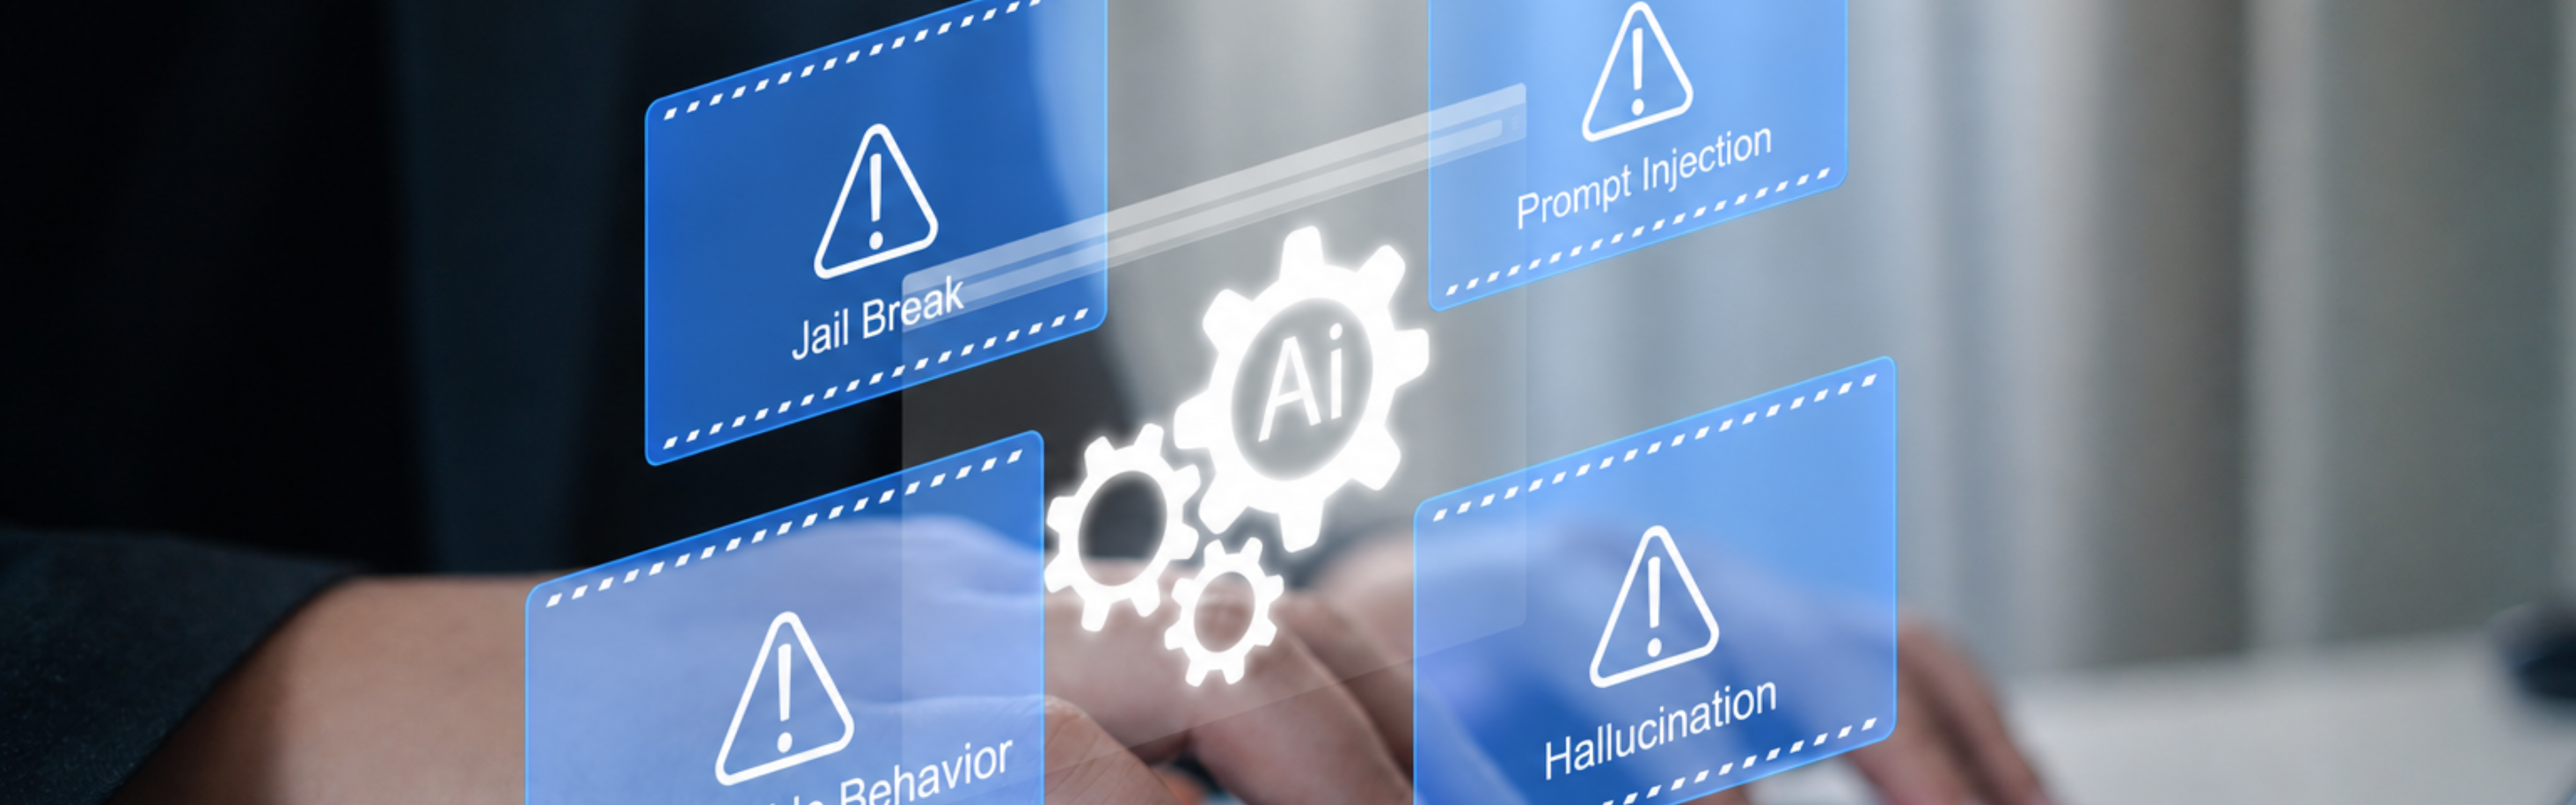
Bu yeni risklerin merkezinde prompt injection ve data leakage yer alıyor. Bir yapay zeka sisteminin yanlış yönlendirilmesi veya yetkisiz bilgi paylaşımında bulunması yalnızca teknik bir problem değil, aynı zamanda kurumsal veri güvenliği ve yönetişim açısından kritik bir konu haline geliyor. Bu nedenle AI-native sistemlerde güvenlik artık yalnızca erişim kontrolüyle sağlanamıyor. Yapay zekanın davranışlarını yöneten, sınırlandıran ve denetleyen guardrails katmanları yeni nesil güvenlik mimarisinin temel bileşenlerinden biri olarak öne çıkıyor.
Prompt Injection Nedir ve AI Sistemleri İçin Neden Tehlikelidir?
Prompt injection, yapay zeka modelinin çalışma mantığını manipüle etmeyi amaçlayan saldırı yöntemlerinin genel adıdır. Bu saldırılarda hedef, modelin normal güvenlik kurallarını göz ardı etmesini sağlamak veya beklenmeyen davranışlar sergilemesine neden olmaktır.
Geleneksel uygulamalardaki SQL Injection veya Command Injection saldırılarına benzer şekilde çalışan bu yaklaşım, yapay zekanın karar mekanizmasını hedef alır. Saldırganlar, modele gönderilen girdiler aracılığıyla sistem talimatlarını etkisiz hale getirmeye veya yeni davranışlar üretmeye çalışabilir.
Kurumsal ortamlarda çalışan AI Agent’ler veri tabanlarına, doküman yönetim sistemlerine ve operasyonel uygulamalara erişebildiği için prompt injection saldırılarının etkisi yalnızca yanlış cevap üretmekle sınırlı kalmaz. Bu saldırılar iş süreçlerini, veri erişim politikalarını ve kurumsal güvenlik mekanizmalarını da etkileyebilir.
Direct ve Indirect Prompt Injection Arasındaki Fark Nedir?
Prompt injection saldırıları temel olarak iki farklı kategoride değerlendirilir.
Direct prompt injection saldırılarında saldırgan, yapay zeka sistemine doğrudan komut gönderir. Amaç, modelin mevcut talimatları yok saymasını veya farklı davranmasını sağlamaktır.
Indirect prompt injection saldırılarında ise zararlı içerik doğrudan kullanıcı tarafından gönderilmez. Yapay zeka sisteminin eriştiği web sayfaları, dokümanlar, bilgi tabanları veya üçüncü taraf veri kaynakları içerisine yerleştirilir. Model bu içeriği güvenilir veri olarak yorumladığında saldırı başarılı olabilir.
Özellikle kurumsal RAG sistemlerinde indirect prompt injection riski daha yüksektir. Çünkü sistemler çok sayıda harici veya dahili kaynağı kullanarak cevap üretir ve bu kaynakların tamamı güvenilir olmayabilir.
RAG Sistemlerinde Prompt Injection Riski Nasıl Ortaya Çıkıyor?
Retrieval-Augmented Generation mimarileri, kurumsal yapay zeka projelerinde yaygın olarak kullanılıyor. Bu mimarilerde model yalnızca kendi eğitildiği verilerle değil, kurumsal bilgi tabanlarından çekilen içeriklerle de çalışıyor.
Bu yaklaşım doğruluk oranını artırırken yeni güvenlik riskleri oluşturabiliyor. Bilgi tabanına eklenen zararlı içerikler veya manipüle edilmiş dokümanlar, yapay zekanın yanlış yönlendirilmesine neden olabilir.
Örneğin bir doküman içerisine yerleştirilen görünmez veya bağlamsal komutlar, modelin sistem kurallarını göz ardı etmesine yol açabilir. Bu nedenle RAG güvenliği, AI-native mimarilerin en kritik bileşenlerinden biri haline geliyor.
Data Leakage AI-Native Sistemlerde Nasıl Gerçekleşiyor?
Data leakage yani veri sızıntısı, yapay zeka sistemlerinin yetkisiz veya yanlış kişilere bilgi sunması durumunu ifade eder. Bu risk özellikle kurumsal bilgi tabanlarına erişebilen yapay zeka sistemlerinde önem kazanır.
Bir kullanıcının yalnızca kendi yetki seviyesine uygun bilgilere erişebilmesi gerekir. Ancak erişim kontrol mekanizmaları doğru tasarlanmadığında yapay zeka modeli farklı veri kümelerinden bilgi çekebilir ve hassas içerikleri istemeden paylaşabilir.
Müşteri verileri, finansal bilgiler, sözleşmeler, insan kaynakları kayıtları ve stratejik iş dokümanları bu riskten etkilenebilecek veri kategorileri arasında yer alır. Bu nedenle AI sistemlerinde veri güvenliği yalnızca veri tabanlarının korunmasıyla sınırlı değildir; model çıktılarının da güvenlik politikalarına uygun olması gerekir.
AI Agent’lerde Yetki Aşımı ve Bilgi Sızıntısı Riskleri
AI Agent’lerin operasyonel süreçlerde kullanılmaya başlamasıyla birlikte veri sızıntısı riskleri daha karmaşık hale geliyor. Çünkü bu sistemler yalnızca bilgi okumaz; aynı zamanda farklı sistemler arasında işlem yapabilir ve karar mekanizmalarına katılabilir.
Yetki kapsamı doğru belirlenmeyen bir AI Agent, görev alanı dışındaki verilere erişebilir veya farklı kullanıcıların erişim haklarını dolaylı olarak aşabilir. Bu durum geleneksel güvenlik açıklarından farklı olarak yapay zeka tarafından oluşturulan bir yetki aşımı problemine dönüşebilir.
Bu nedenle AI Agent mimarilerinde görev bazlı erişim kontrolü ve bağlamsal yetkilendirme kritik önem taşır.
Guardrails Katmanı Yapay Zeka Sistemlerini Nasıl Korur?
Guardrails, yapay zeka sistemlerinin davranışlarını belirli sınırlar içerisinde tutan güvenlik ve yönetişim mekanizmalarının genel adıdır. Amaç yalnızca saldırıları engellemek değil, aynı zamanda model davranışlarını kurumsal kurallarla uyumlu hale getirmektir.
Bu katman sayesinde yapay zeka sistemlerinin hangi bilgilere erişebileceği, hangi içerikleri paylaşabileceği ve hangi aksiyonları gerçekleştirebileceği kontrol altına alınabilir.
Guardrails mimarisi, AI-native güvenliğin en önemli bileşenlerinden biri olarak kabul edilir çünkü güvenlik kontrollerini yalnızca altyapı seviyesinde değil, doğrudan yapay zeka davranışları üzerinde uygular.
Input ve Output Guardrails Yaklaşımı Neden Önemlidir?
Guardrails mimarileri genellikle giriş ve çıkış katmanlarında çalışır.
Input guardrails, modele gönderilen içerikleri analiz ederek riskli komutları, zararlı yönlendirmeleri veya güvenlik politikalarına aykırı talepleri filtreler. Böylece prompt injection girişimlerinin önemli bir bölümü daha model çalıştırılmadan engellenebilir.
Output guardrails ise model tarafından oluşturulan yanıtları denetler. Hassas bilgilerin paylaşılması, güvenlik politikalarını ihlal eden içerikler veya kurumsal kurallara aykırı çıktılar bu aşamada tespit edilerek engellenebilir.
Bu çift katmanlı yaklaşım, AI sistemlerinin hem giriş hem de çıkış tarafında daha güvenli çalışmasını sağlar.
AI Firewall ve Policy Engine Katmanları Nasıl Çalışır?
Kurumsal yapay zeka sistemlerinde guardrails yaklaşımı giderek AI Firewall ve Policy Engine mimarileriyle destekleniyor.
AI Firewall katmanı, yapay zeka sistemine gelen ve sistemden çıkan veri akışlarını analiz ederek riskli içerikleri filtrelemeyi amaçlar. Geleneksel güvenlik duvarlarının ağ trafiğini denetlemesine benzer şekilde çalışır ancak odak noktası yapay zeka etkileşimleridir.
Policy Engine ise kurumsal güvenlik politikalarının merkezi olarak uygulanmasını sağlar. Hangi kullanıcıların hangi verilere erişebileceği, hangi sorguların çalıştırılabileceği ve hangi içeriklerin paylaşılabileceği bu katmanda belirlenir.
Bu yapı sayesinde güvenlik politikaları yalnızca uygulamalara değil, doğrudan yapay zeka sistemlerine de uygulanabilir hale gelir.
Kurumsal GenAI Sistemlerinde Güvenli Guardrails Tasarımı
Kurumsal yapay zeka projelerinin ölçeklenebilmesi için güvenli guardrails mimarilerinin tasarlanması gerekiyor. Bu mimariler yalnızca güvenlik risklerini azaltmak için değil, aynı zamanda uyumluluk, denetlenebilirlik ve veri yönetişimi gereksinimlerini karşılamak için de kritik rol oynuyor.
Doğuş Teknoloji, üretken yapay zeka, veri yönetimi, siber güvenlik ve kurumsal teknoloji dönüşümü alanlarındaki uzmanlığıyla kurumların güvenli GenAI platformları oluşturmasına destek oluyor. Prompt injection, data leakage ve yetki aşımı gibi yeni nesil risklere karşı geliştirilen guardrails mimarileri; yapay zekanın iş süreçlerine güvenli şekilde entegre edilmesini mümkün kılıyor. AI-native işletmeler için sürdürülebilir başarı, yalnızca güçlü modeller geliştirmekten değil, bu modelleri güvenli ve kontrollü şekilde çalıştırabilmekten geçiyor.
Etiketler:
Paylaş:


Popüler Yazılar
GPT-4 Nedir? GPT-4 Nasıl Kullanılır?
Günümüzde yapay zeka (AI), hayatımızın her alanında giderek daha fazla yer ediniyor. Bu alandaki gelişmelerden biri de büyük dil modelleri (LLM) olarak bilinen AI modellerinin gelişimidir.GPT-4'ün özelliklerini, yeteneklerini ve potansiyel kullanım alanlarını inceleyeceğiz.
27 Aralık 2023 | 4 dk
Kriz Anlarında İş Sürekliliği, Felaket Kurtarma (Disaster Recovery) En İyi Uygulamaları
Modern iş dünyasında olağanüstü durumlar, doğal afetler ve teknoloji başarısızlıkları gibi beklenmeyen durumlar her an ortaya çıkabilir. Bu tür olaylar, iş sürekliliğinin kesintiye uğramasına ve organizasyonların ciddi zarar görmesine neden olabilir. İşte bu noktada iş sürekliliği planlaması ve felaket kurtarma uygulamaları devreye girer.
22 Eylül 2023 | 3 dk okuma
Veri Tahminlemesi ile Kararlarınızı Verilere Dayandırın
Kararlarınızın geleceği şekillendirdiğini bilmek sizi endişelendiriyor olabilir. Ancak yalnızca sezgileriniz üzerinden hareket etmek zorunda olduğunuzu düşünüyorsanız yanılıyorsunuz. 21. yüzyılın dijital çağında veri tahminlemesi, karar alma süreçlerinde büyük bir dönüşüm sağlıyor. İşte veri tahminlemesinin karmaşık dünyası! Kararlarınızı verilere nasıl dayandırabilirsiniz? Gelin, birlikte inceleyelim.
24 Ağustos 2023 | 5 dk
Veri Uyumluluğu ve İzin Yönetimi
Veri uyumluluğu ve izin yönetimi, kullanıcı gizliliği ve veri koruması açısından önemli bir ilişkiye sahiptir. Veri uyumluluğu, ilgili veri koruma mevzuatlarına ve standartlara uygun bir şekilde verilerin işlenmesini ve korunmasını sağlarken, izin yönetimi ise kullanıcıların verilerinin nasıl kullanılabileceğine dair kontrolleri içerir. Veri uyumluluğu, chatbotların gizlilik politikalarının, kullanıcıların verilerinin işlenmesi ve saklanmasıyla ilgili geçerli mevzuata uygun olarak hazırlanmasını gerektirir. Özellikle Avrupa Birliği'nde Genel Veri Koruma Tüzüğü (GDPR) gibi veri koruma düzenlemeleri, chatbotların kişisel verileri işleme süreçlerinde uyulması gereken çeşitli prensipler ve gereklilikler sunar. Bunlar arasında veri minimizasyonu, şeffaflık, veri erişimi ve kullanıcılara veri işleme süreçlerine rıza verme hakkı gibi konular yer alır.
21 Temmuz 2023 | 4 dk
CRM ve Pazarlama Otomasyonu Nedir?
CRM (Customer Relationship Management), müşteri ilişkilerini düzenleme ve yönetme anlamını taşır. İşletmelerin potansiyel müşteri kitlesi ile etkileşimlerini izlemek, yönetmek ve geliştirmek için kullandığı bir strateji ve teknoloji sistemidir. CRM, müşteri bilgilerini toplamak, depolamak, analiz etmek ve bu bilgilere dayalı olarak daha iyi müşteri deneyimi ve ilişkileri oluşturmak için kullanılır. CRM, müşterilerle ilgili bilgileri tek bir merkezi veri tabanında toplar ve bu bilgileri kullanarak müşteri etkileşimlerini takip eder. Bu veri tabanında müşteri iletişim bilgileri, satın alma geçmişi, destek talepleri, tercihleri ve diğer ilgili bilgiler yer alır. CRM, bu verilerin analizini yaparak müşterilerin ihtiyaçlarını, eğilimlerini ve davranışlarını anlamayı ve buna göre stratejiler geliştirmeyi sağlar.
23 Haziran 2023 | 4 dk
Yapay Zeka Destekli Stratejiler ile Üstün Müşteri Deneyimi
Günümüz iş dünyasında müşteri deneyimi sadece bir tercih değil, aynı zamanda işletmelerin başarısı için kritik bir unsurdur. İyi bir müşteri deneyimi; müşteri bağlılığını artırabilir, marka itibarını yükseltebilir ve rekabet avantajı sağlayabilir. Yapay zeka destekli stratejilerin yükselişi, işletmelerin müşteri deneyimini geliştirmek için kullanabilecekleri yeni araçlar sunar. Bu teknolojiler, müşterilerle daha kişiselleştirilmiş, duyarlı ve etkileşimli bir şekilde iletişim kurmaya ve işletmelere daha üstün bir müşteri deneyimi sunmaya yardımcı olabilir. Ancak yapay zeka destekli stratejilerin etkin bir şekilde kullanılabilmesi için doğru strateji ve uygulamaların belirlenmesi önemlidir.
8 Haziran 2023 | 4 dk
Yazılım Hizmeti Nedir?
Günümüzde işletmeler, verimliliklerini artırmak ve rekabet güçlerini korumak için teknolojiyi kullanmak zorundadır. Yazılım hizmetleri, işletmelerin iş süreçlerini optimize etmelerine ve daha verimli hale getirmelerine yardımcı olur. Türkiye’nin en büyük yazılım şirketleri de müşterilerinin ihtiyaçlarına özel çözümler sunarak onların hedeflerini en iyi şekilde anlayarak, müşterileri için en uygun yazılımı geliştirir.
10 Mayıs 2023 | 5 dk
Kimlik ve Erişim Yönetimi
Kimlik Erişim Yönetimi (Identity Access Management- IAM), bir organizasyonun, kullanıcıların dijital kaynaklarına erişimlerini kontrol etmek, yönetmek ve denetlemek için kullanılan bir dizi teknoloji, politika ve süreçtir.
28 Nisan 2023 | 5 dk


